通用专题 · 04 · 方法论
AI 跑测试
生成 + 跑 + 修
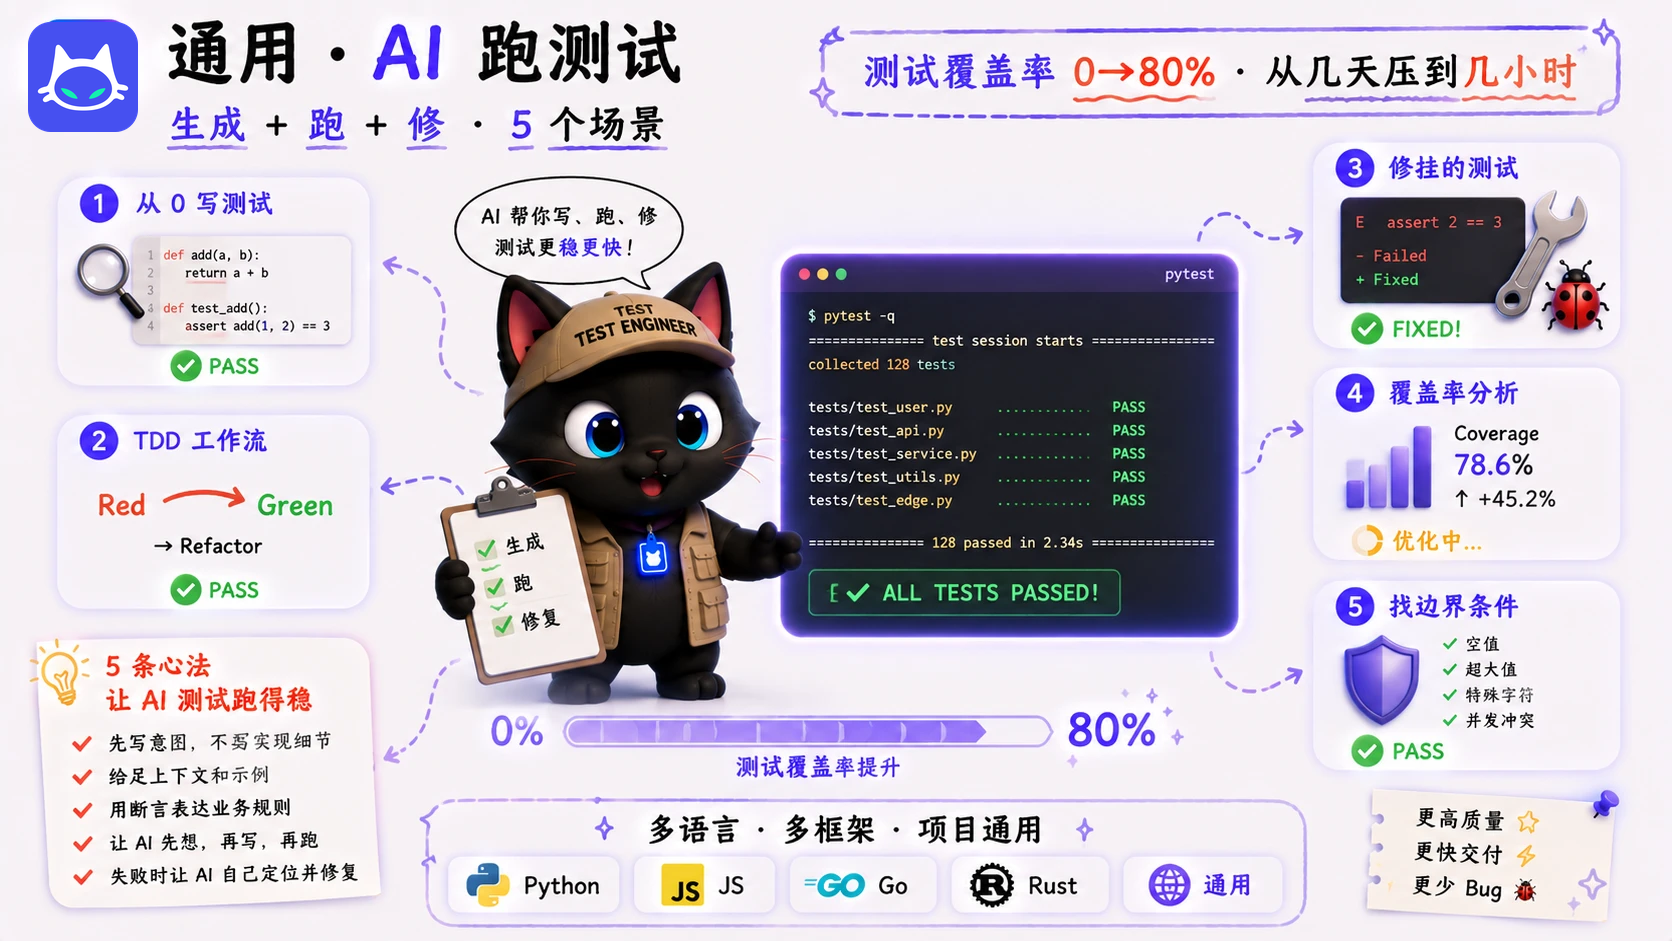
从 0 到 80% 覆盖率,时间从「几天」压到「几小时」。5 个场景直接抄 + 5 条让 AI 测试跑得稳的心法。
为什么用 AI 跑测试
程序员第二讨厌的事(紧跟写文档之后):写测试。AI 在测试上是真·神器 — 从 0 到 80% 覆盖率,时间从「几天」压到「几小时」。
AI 测试的甜区:
- 读代码 → 生成测试用例(你只审核)
- 跑测试 → 失败自动修
- 覆盖率分析 + 补缺
- 边界条件 / 异常路径自动想到
5 个场景 · 直接抄
1 · 从 0 写测试
给现有函数补单测
老代码没有测试,AI 一次性给你补齐。
读完 src/utils/string_helpers.py 后,给每个函数写一份单元测试(pytest 风格)。每个函数至少 3 个用例:① 正常路径 ② 边界条件 ③ 异常输入。测试文件叫 test_string_helpers.py。
2 · TDD 工作流
先写测试,再让 AI 实现
反过来 — 你写测试,AI 写实现到测试通过。代码质量出奇地稳。
我写了一份测试 test_user_signup.py 描述「用户注册」功能。读完测试后,给我实现 src/user/signup.py 让所有测试通过。不要改测试文件,只动实现。
3 · 修失败测试
跑测试 + 错了自己修
跑了一遍测试 5 个挂的 — 让 AI 一个个修。每修一个跑一遍验证。
跑 `pytest tests/` 看哪些挂了。挑前 3 个,每个:① 看错误信息 ② 找出对应源码 ③ 决定是 bug 在源码还是测试 ④ 修好并重跑确认。一次只修一个,跑过了再下一个。
4 · 覆盖率分析
找哪里漏测了
跑覆盖率工具,让 AI 看报告 + 补关键漏洞。
跑 `pytest --cov=src/ --cov-report=term-missing`。看哪些函数 / 分支没覆盖。挑 TOP 3「最关键且未覆盖」的(错了影响大的优先),给它们补测试。不要为了凑覆盖率瞎写。
5 · 边界 / 异常
让 AI 想出你没想到的破坏方式
常规测试好写,刁钻边界难想 — 这是 AI 的强项。
这是「文件上传」功能的现有测试。扮演一个想搞坏它的攻击者,列出 10 种没被测到的边界 / 异常场景(空文件 / 巨大文件 / 路径穿越 / 重复名 / 并发等)。每个写一个测试用例。
语言 / 框架适配
Python
pytest
AI 最熟,效果最稳
- fixture / parameterize 都熟
- mocker 用法老练
- 新手友好
JS / TS
vitest / jest
前端首选
- vitest 体验比 jest 顺
- React Testing Library 也熟
- 注意 mock 写法稍复杂
Go / Rust
go test / cargo test
编译型语言一样能玩
- Go 的 table-driven test AI 写得好
- Rust 的 #[cfg(test)] 模板熟
- integration test 也能搞
让 AI 测试跑得稳的 5 条心法
① 给现有测试做参考 · 「按这个项目现有的 test_xxx 风格写」
② 一次一个文件 · 让 AI 啃完一个再下一个,不要一次让它写 10 个
③ 跑了再说 · AI 写完立刻跑一遍,没跑过的测试都不算数
④ 别为覆盖率瞎写 · 100% 覆盖率没意义,覆盖关键路径才有意义
⑤ 别让 AI 改测试来"修 bug" · 不老实,要明确指示「源码错了改源码,测试错了改测试」
3 个常见踩坑
AI 写"看起来对"但其实 trivial 的测试 · 比如 `assert True`。审查时看 assert 是否有意义
AI 改测试来"修" bug · 测试挂了它把 assert 改宽就过了 — 明确禁止,让它只改源码
mock 用得太凶 · 全 mock 测出来的代码没用。让 AI 优先用真实对象
FAQ
哪个模型写测试最好
Claude Sonnet / Opus 在工程实践上最稳。GPT-5 在边界条件思考上更强。先 Sonnet 跑大批量,难题切 Opus / GPT-5。
能不能让 AI 把整个项目的测试都跑通
能,但慢且贵。更聪明的做法:① 让 AI 列出所有挂的测试 ② 按优先级排 ③ 你挑前 5 个让它修,跑通了再继续。一口吃不下大象。
TDD 真的可行吗
非常可行 — 而且 AI 让 TDD 比手写时代容易得多。你专注写测试(描述需求),AI 负责实现。这其实是 AI 时代的最佳实践之一。
下载暴喵 AI 管家
一站装好 Claude Code / Cursor / Codex CLI · 跑测试第一步